主题
Transformer 架构
0. 先建立一个总印象
Transformer 可以理解成一个“让每个 token 根据其他 token 的重要性,动态聚合信息”的神经网络架构。
它最核心的公式只有一个:
其中:
- Q(Query):我正在寻找什么信息?
- K(Key):我拥有什么信息,方便别人匹配?
- V(Value):真正要被取走、聚合的信息。
- :计算 token 与 token 之间的相关程度。
- :缩放,避免点积过大导致 Softmax 梯度过于尖锐。
- M(Mask):禁止模型看到某些位置。
- Softmax:把分数变成“注意力权重”。
一句话记忆:
Q 决定“我要找什么”,K 决定“你和我匹不匹配”,V 决定“匹配后拿走什么”。
1. Transformer 为什么会出现?
在 Transformer 之前,序列任务经常使用 RNN / LSTM / GRU。
RNN 的一个基本思路是:
text
x1 → h1 → x2 → h2 → x3 → h3 → ...问题在于:
- 计算难以完全并行:后面的时刻依赖前面的隐藏状态。
- 长距离依赖困难:句子很长时,早期信息经过很多步传播,容易丢失。
- 训练效率较低:尤其是长序列。
Transformer 换了一种思路:
text
x1 ─┐
x2 ─┼─→ Self-Attention → 每个 token 直接看其他 token
x3 ─┼
x4 ─┘也就是:让一个 token 直接和整个序列建立联系。
2. Transformer 的整体结构
经典 Transformer 是一个 Encoder-Decoder 架构。
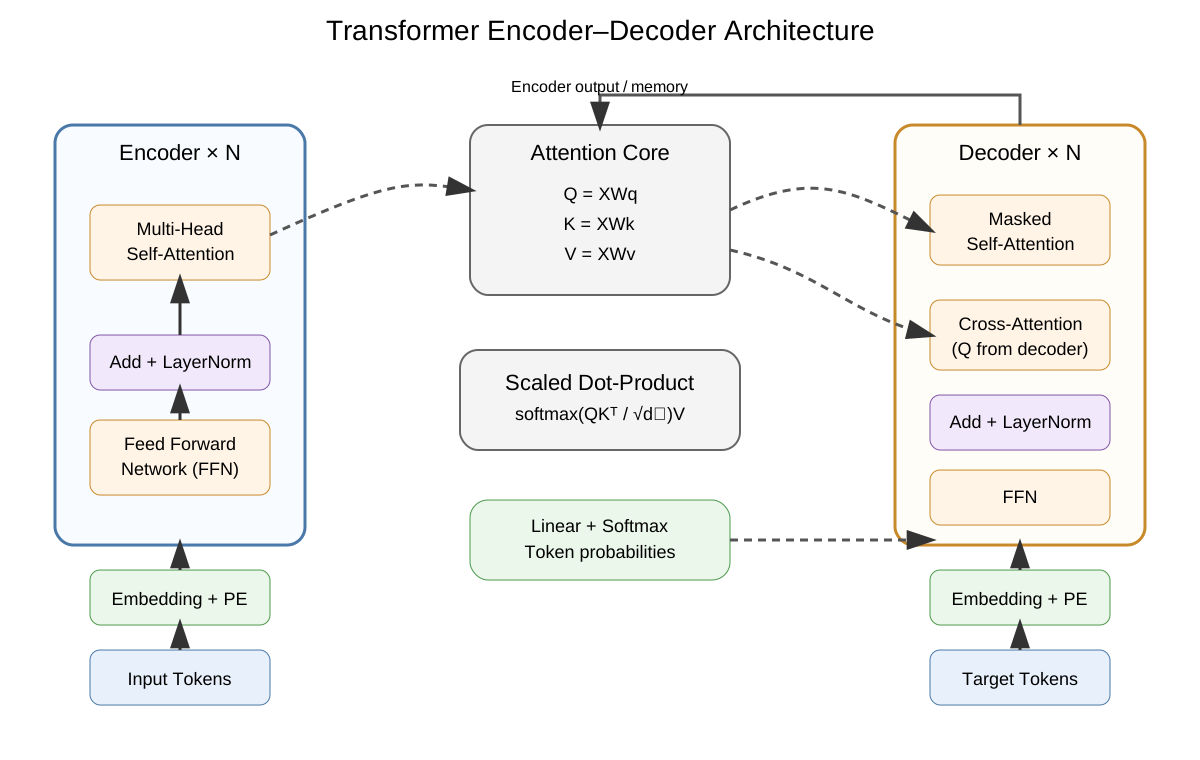
经典论文中的结构可以拆成两半:
text
Encoder                         Decoder
┌───────────────┐               ┌────────────────────┐
│ Self-Attention│               │ Masked Self-Attn   │
├───────────────┤               ├────────────────────┤
│ FFN           │               │ Cross-Attention    │
└───────────────┘               ├────────────────────┤
                                │ FFN                │
                                └────────────────────┘
2.1 Encoder 做什么?
Encoder 的主要目标是:
把输入序列编码成包含上下文信息的表示。
例如:
text
我 喜欢 苹果通过 Self-Attention 后,每个 token 的向量不再只表示自己,而会包含上下文信息。
2.2 Decoder 做什么?
Decoder 的主要目标是:
根据已经生成的内容,以及 Encoder 提供的输入信息,逐步生成输出。
例如机器翻译:
text
中文输入:我喜欢苹果
↓ Encoder
语义表示
↓ Decoder
I → like → apples
3. Encoder:一层到底做了什么?
一个典型的 Transformer Encoder Layer 可以理解成:
text
输入 X
 ↓
Multi-Head Self-Attention
 ↓
Add + LayerNorm
 ↓
Feed Forward Network
 ↓
Add + LayerNorm
 ↓
输出
实际现代实现中,LayerNorm 的放置方式还存在 Pre-LN / Post-LN 两种常见变体。经典论文更接近 Post-LN,而 GPT 类模型通常更接近 Pre-LN。
先记住核心组件就够了:
- Self-Attention
- Multi-Head
- FFN
- Residual Connection
- LayerNorm
4. Self-Attention 是整个 Transformer 的核心
4.1 先用一个直觉理解
考虑一句话:
text
小明 把 苹果 放进了 冰箱, 因为 它 很凉。当模型理解“它”时,应该重点关注哪些词?
它可能需要关注:
text
它 → 苹果
它 → 冰箱
具体权重取决于上下文。
这就是 Attention 的思想:
当前 token 根据上下文动态决定应该从哪些 token 获取多少信息。
4.2 Query、Key、Value 到底是什么?
设输入矩阵为:
其中:
- n:序列长度
- :隐藏维度
通过三个不同的线性层得到:
可以把它记成:
text
             ┌→ Q:我要找什么?
X ─ Linear ──┼→ K:我有什么特点?
             └→ V:真正的信息是什么?
注意:Q、K、V 都来自 X,并不是三个不同的数据集。
5. Scaled Dot-Product Attention
这是 Transformer 中最核心的数学过程。

公式:
加上 Mask 后是:
逐步拆开。
5.1 第一步:计算 QKᵀ
假设只有 3 个 token:
text
猫 喜欢 鱼Q 的形状:
text
[3, d]K 的形状:
text
[3, d]所以:
text
Q @ K.T得到:
text
[3, 3]可以理解成一个 token-to-token 的相关性矩阵:
text
           猫    喜欢    鱼
猫         ?      ?      ?
喜欢       ?      ?      ?
鱼         ?      ?      ?
每个数字都代表一个 query 对某个 key 的匹配程度。
5.2 为什么要除以 √dk?
如果 很大,点积结果的绝对值可能会很大。
例如:
text
[10, 12, 11] → softmax相比:
text
[1.0, 1.2, 1.1] → softmax前者会非常尖锐。
Softmax:
输入过大可能使最大值接近 1,其余值接近 0,训练时容易造成梯度问题。
因此使用:
这是一个非常重要的稳定技巧。
6. Softmax:把“相关程度”变成“权重”
例如某一行 Attention Score:
text
[1.0, 2.0, 3.0]经过 Softmax 后变成类似:
text
[0.09, 0.24, 0.67]这些数有两个重要特点:
- 都在 0~1 之间。
- 加起来等于 1。
所以可以把它理解成:
我应该从每个 token 身上“拿多少信息”。
7. 最后一步:Attention Weights × V
得到注意力权重后:
最终:
也就是一个加权求和。
例如:
text
Attention 权重
[0.1, 0.2, 0.7]

V1 = 10
V2 = 20
V3 = 30
那么:
text
Output = 0.1×10 + 0.2×20 + 0.7×30
       = 26
所以 Attention 本质上可以理解成:
根据相关性,对 Value 做加权平均。
8. Multi-Head Attention 为什么需要多个 Head?
单个 Attention 只能学到一种关系。
但自然语言中有很多类型的关系:
- 语法关系
- 主谓关系
- 指代关系
- 位置关系
- 语义关系
- 长距离依赖
因此 Transformer 使用多个 Attention Head。
text
                  ┌→ Head 1 → 语法关系
X → Multi-Head ───┼→ Head 2 → 指代关系
                  ├→ Head 3 → 语义关系
                  └→ Head 4 → 位置关系
                         ↓
                     Concat
                         ↓
                     Linear
每个 Head 都有自己的:
text
WQ, WK, WV然后把多个 Head 的输出拼接起来,再过一个线性层:
其中:
9. Multi-Head 的维度怎么算?
假设:
text
d_model = 512
num_heads = 8
通常每个 head 的维度:
因此:
text
输入: [batch, seq_len, 512]

分成 8 个 Head:
[batch, 8, seq_len, 64]
每个 Head 独立计算 Attention。
最后拼回来:
text
[batch, 8, seq_len, 64]
        ↓ concat
[batch, seq_len, 512]
一个非常重要的检查条件:
d_model 通常必须能被 num_heads 整除。
10. Mask:Transformer 初学者最容易混淆的地方
Mask 的核心目的只有一句话:
某些位置不允许参与 Attention。

主要有两类:
- Padding Mask
- Causal Mask / Look-ahead Mask
10.1 Padding Mask
一个 batch 中不同句子长度可能不同,所以通常要补 <pad>:
text
句子1:我 喜欢 苹果 <pad> <pad>
句子2:我 喜欢 吃 苹果  香蕉
模型不应该关注 <pad>。
因此把对应位置 mask 掉。
典型实现思路:
python
scores = scores.masked_fill(mask, float('-inf'))经过 Softmax 后:
text
exp(-∞) ≈ 0因此这些位置的 Attention 权重约等于 0。
10.2 Causal Mask / Look-ahead Mask
这是 GPT 类自回归模型最重要的 Mask。
假设目标序列:
text
我 喜欢 吃 苹果预测“吃”时,模型只能看到:
text
我 喜欢不能提前看到:
text
苹果否则训练时模型就“作弊”了。
Attention 矩阵通常使用下三角:
text
1 0 0 0
1 1 0 0
1 1 1 0
1 1 1 1
其中:
text
1 = 可以看
0 = 不可以看
数学上常把不能看的地方加上 :
text
[ 0, -∞, -∞, -∞ ]
[ 0,  0,  -∞, -∞ ]
[ 0,  0,   0, -∞ ]
[ 0,  0,   0,   0 ]
这样 Softmax 后,上三角权重就接近 0。
11. Encoder Self-Attention 与 Decoder Masked Self-Attention 的区别
这是考试、面试和源码阅读中非常常见的问题。
Encoder Self-Attention
一般允许看到完整输入:
text
我 ←→ 喜欢 ←→ 苹果所以通常没有 causal mask。
Decoder Self-Attention
生成第 t 个 token 时,只能看自己和过去:
text
过去 ← 当前

未来:禁止看到
所以使用 causal mask。
12. Decoder 中还有 Cross-Attention
Cross-Attention 是 Decoder 与 Encoder 连接的关键。
在 Cross-Attention 中:
text
Q ← Decoder
K ← Encoder
V ← Encoder
也就是说:
Decoder 根据自己当前生成的信息,去“查询” Encoder 的输出。
可以记忆成:
text
Encoder:我把输入内容整理好了

Decoder:我现在需要什么信息?

Encoder:这是对应的信息
这和 Self-Attention 的区别非常重要:
| 类型 | Q 来源 | K 来源 | V 来源 |
|---|---|---|---|
| Encoder Self-Attention | Encoder | Encoder | Encoder |
| Decoder Masked Self-Attention | Decoder | Decoder | Decoder |
| Decoder Cross-Attention | Decoder | Encoder | Encoder |
13. 为什么 Transformer 需要位置编码?
Attention 本身对顺序并不敏感。
例如:
text
我 爱 你和:
text
你 爱 我如果只把 token embedding 放进去,模型并不知道顺序的重要性。
因此需要告诉模型:
text
这是第 0 个位置
这是第 1 个位置
这是第 2 个位置
经典 Transformer 使用正弦/余弦位置编码:
然后:
14. 为什么现在很多大模型不直接使用经典正弦位置编码?
现代 LLM 常见的位置处理方法包括:
- RoPE(Rotary Positional Embedding)
- ALiBi
- Learned Positional Embedding
- 其他相对位置方案
其中 RoPE 在现代 decoder-only LLM 中非常常见。
初学阶段不必马上深入所有变体,先掌握:
Attention 自身没有顺序概念,所以必须通过某种机制注入位置信息。
这是最重要的结论。
15. Feed Forward Network(FFN)是什么?
Attention 负责:
token 与 token 之间的信息交互。
FFN 负责:
对每一个 token 的表示做更深的非线性变换。
典型形式:
常见实现是:
text
Linear
↓
激活函数(GELU / SwiGLU 等)
↓
Linear
经典 Transformer 可以写成:
text
x → Linear → ReLU → Linear → output而现代 LLM 更常使用 GELU、SwiGLU 等激活结构。
一个非常好记的对比:
text
Attention:不同 token 之间交流
FFN:每个 token 自己“思考”
16. Residual Connection:为什么要加残差?
Transformer 中经常看到:
也就是:
text
        ┌──────────────┐
x ───────┤              ↓
  ↓     F(x)          Add
      ───────────────→ +
这样做可以让信息和梯度更容易传播。
从训练角度看:
text
没有残差:
x → Layer1 → Layer2 → Layer3 → ...

有残差:
x ───────────────────→ +
 \→ Layer1 → Layer2 → /
即使某个子层学习得不好,也可以保留原输入信息。
17. LayerNorm:为什么 Transformer 需要归一化?
LayerNorm 用于稳定隐藏状态的尺度,让训练更容易。
它的核心思想是对特征维度进行标准化,然后再通过可学习参数恢复表达能力。
直觉上可以理解为:
不要让每一层的数值分布随着深度变得越来越难控制。
Transformer 中常见两种结构:
Post-LN
text
x → Attention → Add → LNPre-LN
text
x → LN → Attention → Add现代深层语言模型里 Pre-LN 非常常见,因为深层训练通常更稳定。
18. 把 Encoder Layer 完整串起来
可以记成:
text
                ┌───────────────────────────┐
                │                           ↓
X → LayerNorm → Self-Attention → Residual Add
                                      ↓
                                  LayerNorm
                                      ↓
                                      FFN
                                      ↓
                                  Residual Add
                                      ↓
                                     Output
如果看到源码,可以重点找:
python
self_attn
norm1 / norm2
ffn / feed_forward
residual
19. PyTorch 手写一个最小 Self-Attention
下面的代码不追求工程性能,只为了帮助理解公式。
python
import math
import torch
import torch.nn.functional as F


def scaled_dot_product_attention(q, k, v, mask=None):
    # q: [batch, heads, seq_len, d_k]
    # k: [batch, heads, seq_len, d_k]
    # v: [batch, heads, seq_len, d_v]

    d_k = q.size(-1)

    # 1. QK^T
    scores = q @ k.transpose(-2, -1)

    # 2. 缩放
    scores = scores / math.sqrt(d_k)

    # 3. Mask
    if mask is not None:
        scores = scores.masked_fill(mask, float("-inf"))

    # 4. Softmax
    attn = F.softmax(scores, dim=-1)

    # 5. 加权求和
    output = attn @ v

    return output, attn
对应公式:
text
scores = QK^T / sqrt(d_k)
attn   = softmax(scores)
output = attn @ V
一定要把这三行真正理解:
python
scores = q @ k.transpose(-2, -1)
attn = softmax(scores, dim=-1)
output = attn @ v
这是 Transformer 最核心的计算过程之一。
20. 手写 Causal Mask
python
import torch

seq_len = 4

# True 表示“要屏蔽”
mask = torch.triu(
    torch.ones(seq_len, seq_len, dtype=torch.bool),
    diagonal=1
)

print(mask)
结果类似:
text
False True  True  True
False False True  True
False False False True
False False False False
然后:
python
scores = scores.masked_fill(mask, float("-inf"))这样就能做到:
text
当前位置不能看未来21. 用 PyTorch 自带 MultiheadAttention 实验
python
import torch
import torch.nn as nn

batch_size = 2
seq_len = 5
d_model = 128
num_heads = 8

x = torch.randn(batch_size, seq_len, d_model)

mha = nn.MultiheadAttention(
    embed_dim=d_model,
    num_heads=num_heads,
    batch_first=True,
)

out, weights = mha(x, x, x)

print("x:", x.shape)
print("out:", out.shape)
print("weights:", weights.shape)
这里:
python
mha(x, x, x)表示:
text
Q = x
K = x
V = x
所以这是 Self-Attention。
22. 如何理解一个完整 Transformer 的数据流?
假设输入:
text
I love machine learning大致流程:
text
文本
 ↓
Tokenizer
 ↓
Token IDs
 ↓
Embedding
 ↓
位置相关信息
 ↓
Transformer Blocks
 ├─ Attention
 ├─ Residual
 ├─ LayerNorm
 ├─ FFN
 └─ Residual
 ↓
Hidden States
 ↓
Linear Head
 ↓
Vocabulary logits
 ↓
Softmax
 ↓
下一个 token 的概率
注意:
Transformer 主体本身输出的是隐藏表示,不一定直接输出“词”。真正输出词概率通常还需要一个最终的 Linear / LM Head。
23. GPT、BERT、T5 到底有什么区别?
理解 Transformer 家族最重要的是看:
到底用了哪一部分架构,以及训练目标是什么。
| 模型 | 主要架构 | 典型注意力方式 | 典型任务 |
|---|---|---|---|
| BERT | Encoder-only | 双向 Self-Attention | 分类、抽取、理解 |
| GPT | Decoder-only | Causal Self-Attention | 文本生成 |
| T5 | Encoder-Decoder | Encoder + Decoder | Seq2Seq |
23.1 BERT:Encoder-only
text
输入
 ↓
Encoder
 ↓
双向上下文表示
 ↓
分类 / 抽取 / 问答等
BERT 的特点之一是:
一个 token 可以同时利用左右两边的上下文。
因此它适合“理解”。
23.2 GPT:Decoder-only
text
输入 token
 ↓
Causal Self-Attention
 ↓
预测下一个 token
 ↓
继续生成
例如:
text
今天 天气 很
        ↓
      好
然后:
text
今天 天气 很 好
          ↓
        呀/。
所以 GPT 的训练目标经常可以概括成:
Next Token Prediction(下一个 token 预测)
23.3 Encoder-Decoder
典型流程:
text
输入句子
 ↓
Encoder
 ↓
语义表示
 ↓
Decoder 自回归生成
 ↓
输出句子
翻译、摘要等经典 Seq2Seq 任务非常适合这种结构。
24. 为什么 GPT 只需要 Decoder?
这是很多初学者第一次学习时非常容易疑惑的问题。
关键是:
“Transformer”并不等于“必须同时有 Encoder + Decoder”。
Transformer 是一种基础架构。
后来产生了:
text
Encoder-only
Decoder-only
Encoder-Decoder
三条重要路线。
现代很多大语言模型采用:
text
Decoder-only Transformer因为它天然适合:
text
根据已有 token → 预测下一个 token25. 训练阶段为什么可以并行?
这是 Transformer 相比传统 RNN 很重要的优势。
例如训练:
text
我 喜欢 苹果目标:
text
喜欢
苹果
。
在训练时,可以一次性把整个序列送进模型,并通过 causal mask 保证每个位置只能看到过去。
例如:
text
位置1 → 看 [1]
位置2 → 看 [1,2]
位置3 → 看 [1,2,3]
虽然逻辑上仍然是自回归的,但训练计算可以在 GPU 上并行完成。
这就是为什么 Transformer 训练效率很高。
26. 推理阶段为什么又变成“一个 token 一个 token”?
训练和推理要分开理解。
训练:
text
一次输入整段序列
→ 并行计算所有位置
推理:
text
输入:我喜欢
↓
预测:苹果
↓
输入:我喜欢苹果
↓
预测:。
↓
……
因此生成过程本质上还是自回归的。
这也是为什么大语言模型生成速度与 KV Cache、上下文长度等问题密切相关。
27. KV Cache 是什么?
生成第 t 个 token 时,历史 token 的 K/V 其实已经计算过了。
如果每次都重新计算,会浪费大量计算。
所以保存之前的:
text
K_1, K_2, ..., K_{t-1}
V_1, V_2, ..., V_{t-1}
当新 token 到来时,只需要计算新 token 的 Q/K/V,并把新的 K/V 追加到缓存。
直观理解:
text
没有 KV Cache:
每生成一个词 → 重新计算整个历史

有 KV Cache:
历史 K/V 保存起来
新 token 只算新增部分
这也是理解现代 LLM 推理性能的重要基础。
28. 一个简化版 Transformer Block
下面写一个更完整的教学版模块:
python
import torch
import torch.nn as nn


class TransformerBlock(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout=0.1):
        super().__init__()

        self.norm1 = nn.LayerNorm(d_model)
        self.attn = nn.MultiheadAttention(
            embed_dim=d_model,
            num_heads=num_heads,
            dropout=dropout,
            batch_first=True,
        )

        self.norm2 = nn.LayerNorm(d_model)

        self.ffn = nn.Sequential(
            nn.Linear(d_model, d_ff),
            nn.GELU(),
            nn.Linear(d_ff, d_model),
            nn.Dropout(dropout),
        )

    def forward(self, x, attn_mask=None):
        # Pre-LN + Residual
        h = self.norm1(x)
        attn_out, _ = self.attn(
            h, h, h,
            attn_mask=attn_mask,
            need_weights=False,
        )
        x = x + attn_out

        # FFN + Residual
        x = x + self.ffn(self.norm2(x))

        return x
这段代码已经能对应到 Transformer 的很多核心概念:
text
LayerNorm
↓
Multi-Head Self-Attention
↓
Residual
↓
LayerNorm
↓
FFN
↓
Residual
29. 一个简化版 GPT 风格 Block
GPT 类模型可以进一步概括成:
text
Token Embedding
+
Position Information
        ↓
┌──────────────────────┐
│ Transformer Block    │ × N
│                      │
│ Causal Self-Attention│
│        ↓             │
│      Residual        │
│        ↓             │
│       FFN            │
│        ↓             │
│      Residual        │
└──────────────────────┘
        ↓
      LayerNorm
        ↓
       LM Head
        ↓
    Vocabulary Logits
然后:
python
next_token = logits[:, -1].argmax(dim=-1)就可以选择概率最大的下一个 token(实际生成通常还会使用 temperature、top-k、top-p 等策略)。
30. 训练时的 Loss 是什么?
以语言模型为例,模型输出:
text
logits: [batch, seq_len, vocab_size]每个位置都预测下一个 token。
假设:
text
输入:   我   喜欢   吃
目标:   喜欢 吃     苹果
就会计算每个位置的 Cross Entropy Loss:
PyTorch 常见写法:
python
loss_fn = nn.CrossEntropyLoss()

# logits: [B, T, V]
# targets: [B, T]
loss = loss_fn(
    logits.reshape(-1, logits.size(-1)),
    targets.reshape(-1),
)
这里要理解一个关键点:
模型不是直接“输出一个字符串”,而是在每个位置输出一个词表大小为 V 的概率分布。
31. 参数量大概从哪里来?
一个 Transformer Block 的参数主要来自:
text
Attention 的 Q/K/V/O 投影
+
FFN
+
Norm
如果忽略 bias,Attention 四个投影大概是:
FFN 如果中间维度是 :
如果一个模型有 N 层,Block 参数大致与 N 成正比。
因此:
模型变大通常主要意味着:隐藏维度变大、层数变多、词表/embedding 变大,以及 FFN 规模变大。
32. Transformer 为什么会梯度消失/爆炸?
你之前学习过梯度消失和梯度爆炸,这里可以把它和 Transformer 联系起来。
深层网络中,如果梯度不断乘上某些 Jacobian,可能出现:
text
|gradient| << 1
→ 越传越小
→ 梯度消失
或者:
text
|gradient| >> 1
→ 越传越大
→ 梯度爆炸
Transformer 之所以能做得很深,残差和归一化发挥了关键作用:
text
x → Sublayer → +x残差给梯度提供了更直接的传播路径。
再配合 LayerNorm / Pre-LN,可以显著改善深层训练稳定性。
所以可以把你之前学的知识串起来:
text
深层网络训练难
        ↓
残差连接 + 归一化
        ↓
更稳定的梯度传播
        ↓
可以堆更多 Transformer Blocks
33. Transformer 和 CNN 有什么区别?
非常粗略地看:
CNN
重点是:
text
局部感受野例如一个卷积核只看附近几个像素。
Transformer
重点是:
text
全局 Attention一个 token 理论上可以直接关注任意其他 token。
因此:
text
CNN:局部 → 逐层扩大感受野
Transformer:直接建立全局关系
当然,现代视觉 Transformer、混合模型等会更加复杂,不能简单认为“Transformer 永远比 CNN 好”。
34. Transformer 和 RNN 最大的区别
| 维度 | RNN | Transformer |
|---|---|---|
| 核心机制 | 隐状态递归 | Self-Attention |
| 序列计算 | 强依赖顺序 | 训练时可并行 |
| 长距离依赖 | 较困难 | 更直接 |
| GPU 并行 | 较弱 | 很强 |
| 计算复杂度 | 与序列长度更线性相关 | 标准 Attention 对长度通常是 O(n²) |
这里特别注意:
标准 Self-Attention 的一个核心代价是 形成 注意力矩阵,因此序列长度增加时,显存和计算压力会快速上升。
这也是长上下文研究的重要原因。
35. 为什么长上下文会贵?
假设:
text
seq_len = 1,000Attention 矩阵规模:
text
1,000 × 1,000 = 1,000,000如果:
text
seq_len = 10,000则:
text
10,000 × 10,000 = 100,000,000也就是随着长度平方增长。
所以你后面学习:
- FlashAttention
- Sparse Attention
- Sliding Window Attention
- Linear Attention
- Long Context
都能追溯到同一个问题:
如何降低长序列 Attention 的计算/显存成本?
36. FlashAttention 和普通 Attention 的关系
初学时最容易误解的一点是:
FlashAttention 不是换了一个完全不同的 Attention 公式。
它主要是在 GPU 上更高效地组织计算和内存访问,从而减少中间张量读写,并改善实际速度/显存效率。
所以学习顺序建议:
text
先学懂 Attention 数学
        ↓
再学 Multi-Head
        ↓
再理解 Mask
        ↓
再理解 KV Cache
        ↓
最后学习 FlashAttention
不要一上来就钻 CUDA 优化。
37. 初学者最常犯的 10 个错误
错误 1:以为 Transformer = Encoder + Decoder
不准确。
Transformer 家族可以有:
text
Encoder-only
Decoder-only
Encoder-Decoder
错误 2:以为 Attention 就是“模型在看图片”
Attention 本质上是一个可学习的加权聚合机制。
文本只是其中一个应用。
错误 3:以为 Q/K/V 是三个不同输入
Self-Attention 中:
python
Q = X @ Wq
K = X @ Wk
V = X @ Wv
都来自同一个 X。
错误 4:忘记 QKᵀ 的维度
如果:
text
Q: [B, H, T, D]
K: [B, H, T, D]
那么:
text
K.transpose(-2, -1)
→ [B, H, D, T]
所以:
text
Q @ Kᵀ
→ [B, H, T, T]
这个 [T, T] 就是 Attention score matrix。
错误 5:Mask 的方向弄反
对于 causal mask:
text
当前 token 可以看到自己和过去
不能看到未来
一定结合“预测下一个 token”的任务来理解,而不要死记下三角。
错误 6:认为 Softmax 之前就是概率
不是。
text
QKᵀ是 score / logits。
只有经过 Softmax 后,才得到归一化的注意力权重。
错误 7:认为 FFN 负责 token 之间交流
不是。
FFN 通常作用在每个 token 上,Attention 才主要负责 token 之间的信息混合。
错误 8:以为位置编码就是把位置编号直接加进去
现代模型有很多不同的位置机制,不能简单认为都使用经典 sinusoidal PE。
错误 9:训练和推理完全一样
不是:
text
训练:通常整段并行
推理:自回归逐 token
错误 10:一上来就研究 Transformer 源码
建议顺序:
text
数学公式
→ 手算小例子
→ PyTorch 小代码
→ 看模块结构
→ 再读大模型源码
38. 一个最小的“脑内模型”
当你以后再看到 Transformer,可以强行在脑子里过一遍:
text
① Token 变成向量
        ↓
② 加入位置信息
        ↓
③ Q/K/V
        ↓
④ QKᵀ
        ↓
⑤ / √dₖ
        ↓
⑥ 加 Mask
        ↓
⑦ Softmax
        ↓
⑧ × V
        ↓
⑨ Multi-Head
        ↓
⑩ Linear
        ↓
⑪ Residual + Norm
        ↓
⑫ FFN
        ↓
⑬ Residual + Norm
        ↓
⑭ 重复 N 层
        ↓
⑮ 输出 logits
只要这条链路清楚,Transformer 基本就入门了。
39. 建议的学习路线
第一阶段:必须搞懂
text
1. Token / Embedding
2. Q/K/V
3. QKᵀ
4. Softmax
5. Attention @ V
6. Multi-Head
7. Mask
8. Residual
9. LayerNorm
10. FFN
第二阶段:理解大模型
text
1. Decoder-only
2. Causal LM
3. KV Cache
4. RoPE
5. RMSNorm
6. SwiGLU
7. Weight Tying
8. Sampling
第三阶段:进入工程
text
1. PyTorch Transformer
2. Hugging Face Transformers
3. FlashAttention
4. 混合精度
5. Tensor Parallel
6. Pipeline Parallel
7. Quantization
8. LoRA / PEFT
40. 面试/考试必背公式
Attention
Multi-Head Attention
FFN
Causal Mask
text
当前位置及之前:可见
未来:不可见
41. 一张表总结 Transformer
| 模块 | 作用 | 关键词 |
|---|---|---|
| Tokenizer | 文本变 token | token id |
| Embedding | token → 向量 | dense vector |
| Positional Info | 注入顺序信息 | position |
| Q/K/V | 构造注意力 | query/key/value |
| Attention | 信息聚合 | QKᵀ + Softmax |
| Multi-Head | 学习多种关系 | heads |
| Mask | 禁止访问某些位置 | padding/causal |
| FFN | 非线性变换 | MLP |
| Residual | 改善深层训练 | skip connection |
| LayerNorm | 稳定训练 | normalization |
| KV Cache | 加速生成 | inference |
| LM Head | hidden → vocab | logits |
42. 最后用一个生活化比喻记住 Q/K/V
把 Attention 想成“图书馆借书”:
text
Q:我现在想找“机器学习”相关的资料

K:每本书的标签/关键词

V:书里面真正的内容
模型先计算:
text
Q 和每个 K 有多匹配?得到:
text
[0.1, 0.2, 0.6, 0.1]然后:
text
0.1×V1
+ 0.2×V2
+ 0.6×V3
+ 0.1×V4
最终得到与当前 query 最相关的上下文信息。
这就是 Attention 最核心的直觉。
43. 一句话终极总结
Transformer = 用 Attention 让 token 之间高效交流,再用 FFN 对每个 token 做非线性变换,并通过残差、归一化和位置机制构建一个可以堆得很深的序列建模架构。
而对于 GPT 类大语言模型,可以进一步记成:
Decoder-only Transformer + Causal Self-Attention + FFN + Residual/Norm + Position Mechanism + LM Head = 现代语言生成模型的基础骨架。
附:推荐自己画的最终结构图
text
                    Transformer
                         │
             ┌───────────┴───────────┐
             │                       │
         Encoder-only          Decoder-only
             │                       │
           BERT                     GPT
             │                       │
      双向理解上下文            自回归生成

                         │
                   Encoder-Decoder
                         │
                         T5
继续深入时,可以沿着这条路线学习:
text
Transformer
   ↓
Attention
   ↓
Mask
   ↓
GPT / BERT
   ↓
RoPE / RMSNorm / SwiGLU
   ↓
KV Cache
   ↓
FlashAttention
   ↓
LoRA / Quantization
   ↓
LLM 推理与训练
这条路线会比一开始直接啃大型模型源码更容易建立完整知识体系。